SEO Teknis untuk Website Bisnis: Crawl Budget, Analisis Log Server, dan Masalah Indexing
Isi artikel
- Ringkasan
- Bagaimana mesin pencari bekerja: tiga tahap yang perlu Anda bedakan
- Apa itu crawl budget dan kapan ia penting
- Sumber pemborosan yang paling sering ditemukan
- Alat pertama: Google Search Console
- Alat kedua: analisis log server
- Mengatur apa yang boleh dan tidak boleh dirayapi
- Tautan internal: sinyal prioritas yang paling bisa Anda kendalikan
- JavaScript dan rendering
- Rencana audit 30 hari untuk bisnis menengah
- Kesalahan yang sering terjadi
- Pertanyaan yang sering diajukan
- Penutup
Banyak pemilik website bisnis sudah rajin menulis konten dan memperbaiki judul, tetapi masih heran mengapa halaman penting lama sekali muncul di Google, atau mengapa ratusan halaman tampak "ditemukan tetapi belum diindeks". Penyebabnya sering bukan di kualitas tulisan, melainkan di lapisan teknis: bagaimana mesin pencari menemukan, mengunduh, dan memutuskan menyimpan halaman Anda. Bidang ini disebut SEO teknis, dan tiga konsep di dalamnya paling sering disalahpahami: crawl budget, analisis log server, dan status indeks.
Artikel ini menjelaskan ketiganya dengan bahasa yang bisa dipahami pemilik bisnis dan tim marketing, lengkap dengan langkah audit yang realistis. Kami tidak menjanjikan lonjakan peringkat tertentu, karena peringkat bergantung pada banyak faktor. Yang bisa dijanjikan adalah ini: bila mesin pencari bisa menjangkau halaman yang tepat dengan mudah, konten bagus Anda punya kesempatan yang adil untuk dinilai.
Ringkasan
- Crawl budget adalah jumlah halaman yang bersedia dan mampu dikunjungi mesin pencari pada situs Anda dalam periode tertentu; ia penting terutama untuk situs besar atau sering berubah
- Situs kecil dengan beberapa puluh atau ratus halaman jarang kekurangan crawl budget; masalah mereka biasanya kualitas, duplikasi, atau halaman yang tidak tertaut
- Log server menunjukkan apa yang benar-benar dikunjungi bot, jauh lebih jujur daripada asumsi
- Laporan indeks di Google Search Console memberi tahu alasan sebuah halaman tidak diindeks
- Sumber pemborosan paling umum: parameter URL tak terbatas, filter produk, halaman hasil pencarian internal, rantai redirect, dan halaman error
- Perbaikan teknis terbaik biasanya sederhana: sitemap bersih, canonical konsisten, tautan internal yang jelas, dan server yang cepat
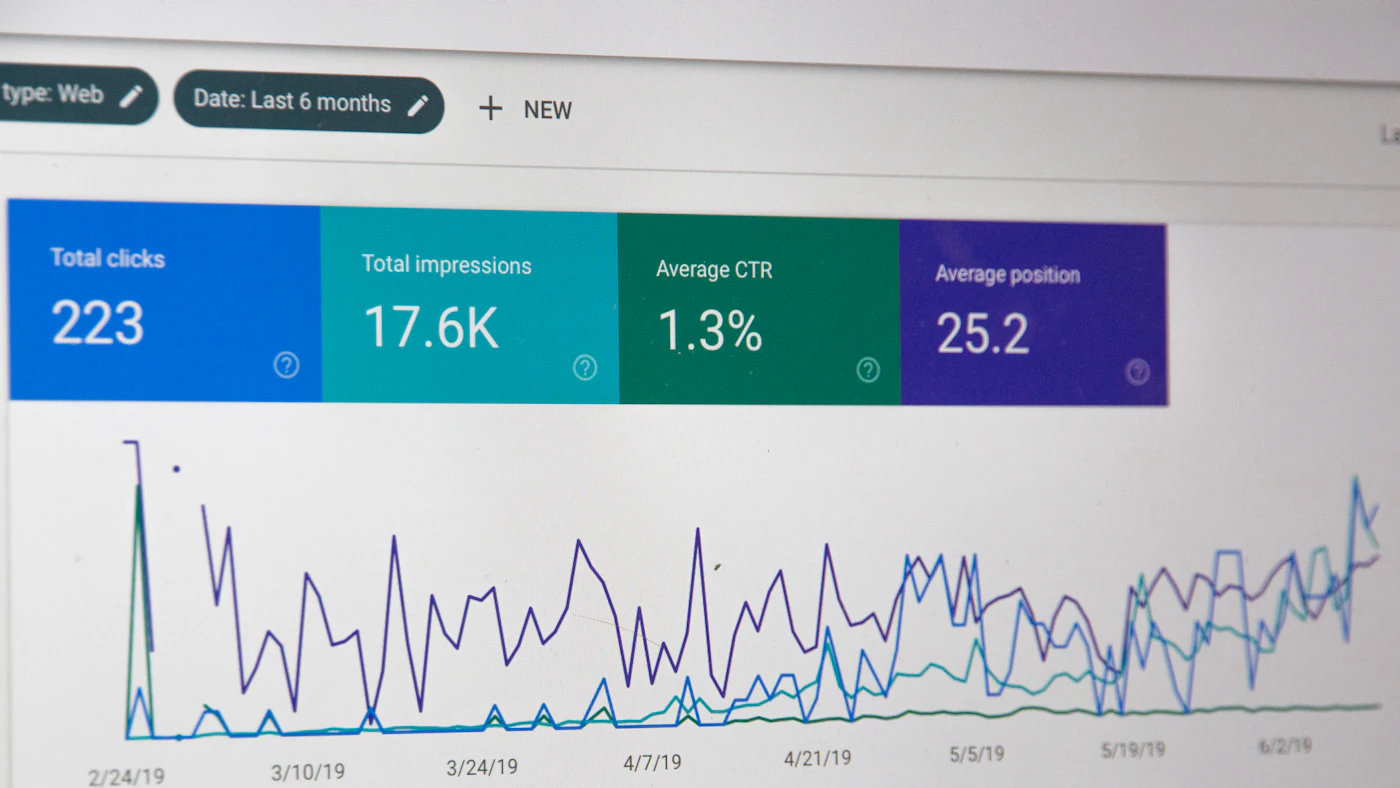
Bagaimana mesin pencari bekerja: tiga tahap yang perlu Anda bedakan
Sebelum sebuah halaman bisa muncul di hasil pencarian, ia melewati tiga tahap yang berbeda. Banyak kekeliruan lahir karena ketiganya dicampur.
- **Crawling (perayapan)**: bot mesin pencari mengunduh halaman Anda. Bila bot tidak pernah menemukan URL atau tidak diizinkan mengaksesnya, halaman itu tidak akan masuk proses berikutnya
- **Indexing (pengindeksan)**: mesin pencari membaca isi halaman, menilai apakah ia layak disimpan, lalu menyimpannya di indeks. Tidak semua halaman yang dirayapi diindeks
- **Ranking (pemeringkatan)**: dari halaman yang terindeks, mesin pencari memilih mana yang paling relevan untuk sebuah pencarian
Bisnis sering langsung sibuk di tahap ketiga, padahal masalah ada di tahap pertama atau kedua. Halaman yang tidak diindeks tidak bisa diperingkat, seberapa pun bagus tulisannya. Karena itu audit SEO teknis selalu dimulai dari dua tahap awal.
Apa itu crawl budget dan kapan ia penting
Crawl budget merupakan gabungan dari dua hal. Pertama, batas laju perayapan: seberapa cepat bot boleh meminta halaman tanpa membebani server Anda. Kedua, permintaan perayapan: seberapa besar keinginan mesin pencari untuk mengunjungi halaman Anda, yang dipengaruhi popularitas, kesegaran, dan kualitas. Panduan resmi dari Google menyebut bahwa topik ini terutama relevan untuk situs yang sangat besar atau yang kontennya berubah sangat cepat, bukan untuk situs bisnis kecil pada umumnya.
Jadi jujur saja: bila website company profile Anda berisi 40 halaman, mengejar "optimasi crawl budget" adalah salah fokus. Perbaikan yang lebih bernilai adalah memastikan setiap halaman penting punya konten unik, judul yang jelas, dan tautan internal. Sebaliknya, crawl budget menjadi isu nyata pada kasus berikut:
- Toko online dengan puluhan ribu produk, varian, dan kombinasi filter
- Portal berita atau blog besar dengan arsip bertahun-tahun
- Marketplace atau direktori dengan halaman yang dibuat otomatis dari basis data
- Situs yang baru bermigrasi dan menghasilkan banyak URL lama yang dialihkan
- Aplikasi web yang secara tidak sengaja membuka banyak URL unik, misalnya parameter sesi atau kalender tak berujung
Pada situs seperti itu, bot bisa menghabiskan kunjungannya pada URL tidak berguna sementara halaman produk baru menunggu berhari-hari. Itulah wujud nyata pemborosan crawl budget.
Sumber pemborosan yang paling sering ditemukan
1. Parameter URL dan navigasi berfacet
Filter warna, ukuran, harga, dan urutan dapat menghasilkan ribuan kombinasi URL yang isinya nyaris sama. Pembahasan lengkapnya ada di SEO toko online: faceted navigation, halaman kategori, dan konten duplikat. Intinya: tentukan kombinasi mana yang punya nilai pencarian dan layak diindeks, sisanya dikelola dengan canonical, noindex, atau pembatasan tautan.
2. Halaman hasil pencarian internal
Setiap kata yang diketik pengunjung pada kotak pencarian situs bisa menghasilkan URL baru. Bila URL itu bisa ditemukan bot, jumlahnya tak terbatas dan kualitasnya rendah. Praktik umum adalah menandai halaman hasil pencarian internal sebagai noindex dan menghindari tautan yang mengarah ke sana dari halaman publik.
3. Rantai dan loop redirect
Satu redirect itu wajar. Rantai redirect (A ke B ke C ke D) membuang kunjungan bot dan memperlambat pengguna. Setelah redesain atau migrasi, rantai seperti ini mudah menumpuk. Panduan redesain dan migrasi website tanpa kehilangan peringkat SEO membahas cara memetakan redirect agar setiap URL lama menuju tujuan akhir dalam satu lompatan.
4. Halaman error dan soft 404
Halaman yang mengembalikan kode 404 atau 500 tetap dikunjungi ulang oleh bot untuk beberapa waktu. Yang lebih licin adalah soft 404: halaman yang tampak kosong atau berisi pesan "tidak ditemukan" tetapi mengirim kode 200 seolah normal. Mesin pencari akan memperlakukannya sebagai halaman tipis berkualitas rendah.
5. Konten tipis dan duplikat
Halaman tag yang hanya berisi satu artikel, halaman arsip per tanggal, atau halaman produk tanpa deskripsi unik menambah jumlah URL tanpa menambah nilai. Mengurangi atau menggabungkan halaman semacam ini sering lebih bermanfaat daripada membuat halaman baru.
6. Server yang lambat
Bila server sering lambat atau mengembalikan error saat dikunjungi bot, mesin pencari akan menurunkan laju kunjungannya agar tidak membebani Anda. Artinya kecepatan server memengaruhi jumlah halaman yang dirayapi. Pembahasan terkait ada di caching dan CDN untuk mempercepat website dan aplikasi bisnis dan Core Web Vitals untuk website bisnis.
Alat pertama: Google Search Console
Search Console gratis dan seharusnya terpasang di setiap website bisnis. Tiga laporan yang paling berguna untuk SEO teknis:
- **Pengindeksan halaman**: menampilkan jumlah halaman terindeks dan alasan halaman yang tidak terindeks, misalnya "Ditemukan, saat ini belum diindeks", "Dirayapi, saat ini belum diindeks", "Halaman dengan pengalihan", "Duplikat tanpa canonical pilihan pengguna", atau "Diblokir oleh robots.txt"
- **Statistik perayapan**: memperlihatkan jumlah permintaan per hari, waktu respons server, dan distribusi kode status. Lonjakan error atau waktu respons yang naik patut dicurigai
- **Sitemap**: menunjukkan berapa URL yang dikirim dan berapa yang benar-benar diindeks
Bacalah alasannya, bukan hanya angkanya. "Ditemukan, belum diindeks" pada ratusan halaman tipis berarti sinyal kualitas atau prioritas rendah. "Duplikat" berarti masalah canonical. "Diblokir robots.txt" berarti ada aturan yang perlu ditinjau, apakah disengaja atau tidak.
Alat kedua: analisis log server
Search Console memberi gambaran dari sisi mesin pencari. Log server memberi gambaran dari sisi Anda: setiap permintaan yang masuk ke server, lengkap dengan waktu, URL, kode status, dan identitas pengunjung (user agent). Dari sini Anda dapat melihat fakta yang tidak tampak di tempat lain.
Apa yang bisa dipelajari dari log
- URL mana yang paling sering dikunjungi bot, dan apakah itu halaman penting atau sampah parameter
- Halaman penting yang jarang atau tidak pernah dikunjungi bot
- Berapa persen kunjungan bot berakhir pada 404, 301, atau 500
- Apakah waktu respons untuk bot lebih lambat daripada untuk pengguna
- Kapan bot paling aktif, sehingga Anda dapat menghindari tugas berat pada jam itu
Cara memeriksanya dengan aman
1. Ambil log akses beberapa minggu terakhir dari server atau CDN Anda; banyak penyedia hosting dan CDN menyediakan ekspor log
2. Saring baris dengan user agent bot yang dikenal, misalnya Googlebot dan Bingbot. Perhatikan bahwa user agent bisa dipalsukan, jadi untuk analisis serius verifikasi alamat IP-nya lewat pencarian DNS terbalik yang dianjurkan mesin pencari
3. Kelompokkan URL berdasarkan pola (misalnya direktori, parameter, atau jenis halaman) dan hitung kunjungan per kelompok
4. Bandingkan dengan daftar halaman yang ingin Anda prioritaskan
5. Catat kelompok yang menyerap banyak kunjungan tetapi bernilai rendah, lalu rancang aturan untuk mengurangi paparannya
Bila log berisi data pribadi seperti alamat IP pengunjung manusia, perlakukan sesuai kebijakan pelindungan data. Hal ini dibahas di pelindungan data pribadi untuk website dan aplikasi. Untuk analisis bot saja, Anda cukup menyimpan baris bot dan menghapus sisanya.
Mengatur apa yang boleh dan tidak boleh dirayapi
robots.txt
File ini memberi tahu bot bagian mana yang sebaiknya tidak dirayapi. Dua hal sering keliru. Pertama, robots.txt mengatur perayapan, bukan pengindeksan: URL yang diblokir masih bisa muncul di indeks tanpa deskripsi bila banyak tautan mengarah kepadanya. Kedua, jika Anda memblokir sebuah halaman, bot tidak bisa membaca tag noindex pada halaman itu. Jadi jangan memblokir halaman yang ingin Anda keluarkan dari indeks dengan noindex.
Meta robots dan header X-Robots-Tag
Tag noindex pada halaman, atau header X-Robots-Tag untuk berkas non-HTML seperti PDF, adalah cara yang tepat untuk meminta halaman tidak diindeks sambil tetap membiarkannya dirayapi.
Canonical
Tag canonical menyatakan versi utama dari sekelompok halaman yang mirip. Ia adalah petunjuk, bukan perintah mutlak, sehingga harus konsisten dengan sinyal lain: sitemap, tautan internal, dan redirect. Bila Anda memiliki versi bahasa berbeda, canonical dan hreflang harus saling selaras, sebagaimana dijelaskan di SEO internasional: hreflang, struktur URL, dan lokalisasi konten.
Sitemap XML
Sitemap adalah daftar URL yang ingin Anda sampaikan kepada mesin pencari. Aturannya sederhana namun sering dilanggar:
- Hanya masukkan URL yang mengembalikan kode 200, bersifat kanonik, dan boleh diindeks
- Jangan memasukkan URL redirect, error, atau noindex
- Gunakan tanggal pembaruan (lastmod) yang jujur, hanya diubah ketika konten benar-benar berubah
- Pecah sitemap besar menjadi beberapa berkas dan daftarkan melalui berkas indeks sitemap
Tautan internal: sinyal prioritas yang paling bisa Anda kendalikan
Bot menemukan halaman dengan mengikuti tautan. Halaman yang tidak ditautkan dari mana pun (yatim piatu) sulit ditemukan walaupun ada di sitemap. Halaman yang ditautkan dari beranda dan dari banyak artikel terkait dianggap lebih penting. Praktiknya:
- Pastikan setiap halaman penting dapat dicapai dalam tiga klik dari beranda
- Tautkan artikel terkait satu sama lain dengan teks tautan yang deskriptif
- Gunakan tautan HTML biasa, bukan hanya tombol yang mengandalkan JavaScript, agar bot dapat mengikutinya
- Hapus atau perbaiki tautan rusak secara berkala
Struktur tautan juga membantu pembaca, sehingga manfaatnya ganda. Pendekatan konten yang saling terhubung ini selaras dengan strategi di blog perusahaan sebagai mesin prospek.
JavaScript dan rendering
Situs yang sangat bergantung pada JavaScript untuk menampilkan konten menambah satu lapisan risiko: mesin pencari harus mengunduh, menjalankan skrip, lalu baru melihat isi akhir. Prosesnya bisa tertunda dan tidak selalu sempurna. Untuk halaman yang ingin dicari orang, rendering di sisi server atau pembuatan halaman statis lebih aman karena isi sudah ada di HTML awal. Uji dengan fitur "Periksa URL" di Search Console untuk melihat HTML yang dilihat Google, dan pastikan judul, heading, teks utama, dan tautan muncul di sana. Pembahasan arsitektur terkait ada di arsitektur website headless untuk bisnis.
Rencana audit 30 hari untuk bisnis menengah
Minggu 1: inventarisasi
- Pasang dan verifikasi Search Console serta Bing Webmaster Tools
- Ekspor daftar halaman terindeks dan tidak terindeks beserta alasannya
- Ambil sampel log server dua sampai empat minggu
Minggu 2: diagnosis
- Kelompokkan URL berdasarkan pola dan hitung kunjungan bot per kelompok
- Daftar rantai redirect, soft 404, dan halaman tipis
- Periksa konsistensi canonical, sitemap, dan tautan internal
Minggu 3: perbaikan
- Bersihkan sitemap, perbaiki redirect, dan tangani parameter bermasalah
- Tambahkan tautan internal ke halaman penting yang yatim piatu
- Gabungkan atau hapus halaman tipis yang tidak punya tujuan
Minggu 4: pemantauan
- Minta pengindeksan ulang untuk halaman penting yang diperbaiki
- Pantau statistik perayapan dan laporan indeks setiap minggu
- Dokumentasikan aturan yang diterapkan agar tidak rusak saat redesain berikutnya
Perubahan teknis butuh waktu untuk terlihat. Menurut pengalaman umum di industri, pengaruhnya biasanya baru tampak setelah beberapa minggu, dan tidak ada jaminan hasil tertentu. Ukur dengan metrik yang jujur: jumlah halaman penting yang terindeks, rasio kunjungan bot ke halaman bernilai, dan tren klik organik dalam periode yang sama.
Kesalahan yang sering terjadi
- Memblokir seluruh situs lewat robots.txt saat lingkungan staging dipindahkan ke produksi, atau sebaliknya lupa memblokir staging
- Menaruh noindex pada template secara tidak sengaja sehingga seluruh jenis halaman hilang dari hasil pencarian
- Mengandalkan alat otomatis yang memberi skor tanpa memahami konteks bisnis
- Mengubah banyak hal sekaligus sehingga dampak sulit dilacak
- Menambah ratusan artikel baru sementara halaman lama yang bagus belum terindeks
- Menyembunyikan konten penting di balik interaksi yang tidak bisa dijalankan bot
Pertanyaan yang sering diajukan
Apakah situs saya dengan 100 halaman perlu mengurus crawl budget?
Biasanya tidak. Fokuskan upaya pada kualitas konten, struktur tautan internal, dan memastikan setiap halaman penting terindeks. Crawl budget baru menjadi prioritas pada situs besar atau yang menghasilkan banyak URL otomatis.
Mengapa halaman baru saya "ditemukan tetapi belum diindeks"?
Mesin pencari mengetahui URL itu tetapi belum menjadwalkan perayapan atau belum menilainya layak disimpan. Penyebab umum: situs masih baru dengan otoritas rendah, konten mirip halaman lain, tautan internal lemah, atau server lambat. Perkuat tautan internal, pastikan konten unik, dan bersabarlah beberapa minggu sebelum menyimpulkan.
Apakah meminta pengindeksan berulang kali membantu?
Tidak. Meminta pengindeksan sekali setelah perbaikan sudah cukup, dan tidak menjamin hasil. Mengulang permintaan tidak mempercepat proses.
Perlukah saya menganalisis log server sendiri?
Untuk situs kecil, laporan Search Console sering sudah memadai. Untuk situs besar, toko online dengan banyak filter, atau setelah migrasi, analisis log memberi bukti yang tidak tersedia di tempat lain dan layak dilakukan sedikitnya sekali per kuartal.
Apakah sitemap menjamin halaman diindeks?
Tidak. Sitemap membantu penemuan, bukan menjamin pengindeksan. Keputusan akhir tetap bergantung pada kualitas dan keunikan halaman.
Penutup
SEO teknis bukan sihir; ia adalah pekerjaan merapikan jalan agar mesin pencari bisa sampai ke halaman terbaik Anda tanpa tersesat di ribuan URL tak berguna. Mulailah dari yang murah dan berdampak: baca laporan indeks, bersihkan sitemap, perbaiki redirect, dan perkuat tautan internal. Bila situs Anda besar atau baru bermigrasi, tambahkan analisis log untuk melihat perilaku bot yang sebenarnya.
Agsora membantu bisnis membangun website dan toko online yang cepat, terstruktur, dan siap dirayapi, termasuk audit SEO teknis dan perbaikan arsitektur. Bila Anda ingin mengetahui mengapa halaman penting belum terindeks, kami siap membantu menelusurinya.
Audit SEO teknis untuk website Anda
Ceritakan jumlah halaman dan kendala indeks yang Anda alami. Tim Agsora akan membantu memetakan prioritas perbaikan yang realistis.
Konsultasi gratisRekomendasi untuk Anda
Bacaan yang berkaitan dengan topik ini
Caching dan CDN: Cara Mempercepat Website dan Aplikasi Bisnis tanpa Menambah Server
Panduan caching berlapis untuk website dan aplikasi bisnis: cache browser, CDN, cache halaman, cache data, invalidasi, header HTTP, risiko data usang, dan cara mengukur dampaknya.
Core Web Vitals (LCP, INP, CLS): Panduan Praktis Memperbaiki Kecepatan Website Bisnis
Arti tiga metrik Core Web Vitals, cara mengecek skor di Search Console dan PageSpeed Insights, penyebab nilai buruk, dan urutan perbaikan yang memberi hasil terbesar.
Kalkulator Harga dan Estimator Online sebagai Lead Magnet Website B2B
Cara membangun kalkulator biaya atau estimator di website jasa B2B yang menghasilkan prospek berkualitas: memilih variabel, menampilkan rentang harga yang jujur, kapan meminta kontak, mengirim hasil ke CRM, SEO untuk halaman kalkulator, dan mengukur dampaknya.
Checklist gratis: memilih software house
24 poin untuk menilai calon vendor sebelum menandatangani kontrak. Bisa disimpan sebagai PDF.
Siap membangun sistem yang tumbuh bersama bisnis Anda?
Diskusikan kebutuhan Anda dengan tim AG·SORA, tanpa biaya, tanpa komitmen.